
Budget d’exploration des grands sites d’affiliation : comment éviter que Googlebot gaspille ses ressources sur des URL inutiles
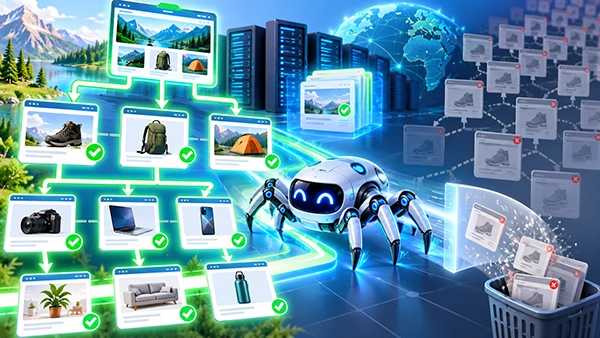
Les grands sites d’affiliation génèrent souvent bien plus d’URL que leurs équipes éditoriales ne l’imaginent. Un site peut comporter quelques milliers d’avis, de comparatifs, de guides et de pages de catégories réellement utiles, tout en exposant des dizaines ou des centaines de milliers de variantes de suivi, de filtres, de résultats de recherche interne, d’archives, de pages d’offres expirées et de combinaisons d’URL dupliquées. Cette différence est importante, car Googlebot ne dispose pas d’un temps illimité pour explorer un même nom d’hôte. Le budget d’exploration n’est pas un facteur de classement direct et tous les sites n’ont pas besoin de le gérer de manière stricte, mais il devient important lorsque les pages utiles sont découvertes ou actualisées trop lentement. Les recommandations de Google sur le budget d’exploration, de nouveau précisées en juillet 2026, concernent principalement les sites très volumineux ou fréquemment mis à jour ainsi que les sites présentant une part importante d’URL connues de Google mais pas encore indexées. Pour les éditeurs travaillant avec l’affiliation, l’objectif pratique est simple : permettre à Google de consacrer davantage de son activité d’exploration aux pages capables d’obtenir une visibilité réelle et d’être utiles aux internautes, plutôt qu’à des variantes d’URL sans valeur de recherche indépendante.
Quand le budget d’exploration devient un véritable enjeu pour un site d’affiliation
Google décrit le budget d’exploration comme l’ensemble des URL que ses systèmes peuvent et souhaitent explorer sur un site. Deux notions se trouvent derrière cette définition. La première est la capacité d’exploration : le volume d’exploration qu’un serveur peut supporter sans devenir lent ou instable. La seconde est la demande d’exploration : l’intérêt que les systèmes de Google accordent à la réexploration de certaines URL en fonction notamment de la taille du site, de la fraîcheur, de la pertinence, de la popularité et de la qualité du contenu. Cette distinction est importante, car un nombre élevé de requêtes d’exploration ne constitue pas automatiquement un signe de bonnes performances SEO. Googlebot peut consacrer beaucoup de temps à des adresses dupliquées ou de faible valeur si le site continue à les générer et à créer des liens vers elles. Un site d’affiliation bien géré ne cherche donc pas à maximiser chaque requête de Googlebot. Il cherche plutôt à rendre l’activité d’exploration plus sélective afin que les avis importants, les comparatifs, les pages commerciales et les contenus éditoriaux récemment mis à jour soient faciles à trouver et à réexplorer.
Les recommandations de Google pour 2026 donnent des exemples approximatifs de sites devant accorder une attention particulière au budget d’exploration : les sites comportant environ un million de pages uniques ou davantage et dont le contenu change modérément souvent, ceux comptant approximativement 10 000 pages uniques ou plus modifiées quotidiennement, ainsi que les sites sur lesquels une proportion importante des URL connues reste en dehors de l’index. Il ne s’agit pas de seuils stricts. Un site d’affiliation ne possédant que 30 000 pages utiles peut tout de même rencontrer un sérieux problème d’exploration si ses filtres, paramètres de suivi et outils internes génèrent des millions de combinaisons d’URL accessibles. L’inverse est également vrai : un site très volumineux disposant de règles d’URL propres, d’un maillage interne cohérent et d’un hébergement stable peut ne rencontrer aucun problème pratique lié au budget d’exploration. Le véritable signal d’alerte n’est donc pas uniquement le nombre de pages, mais l’écart entre les URL que l’entreprise souhaite faire traiter par Google et celles que Googlebot demande réellement.
Pour les éditeurs travaillant avec l’affiliation, les conséquences commerciales prennent généralement la forme d’une découverte plus lente ou d’une actualisation tardive des contenus importants plutôt que d’une simple « pénalité de budget d’exploration ». Une nouvelle page comparative peut rester inconnue plus longtemps, un avis mis à jour peut mettre du temps à être réexploré ou une page liée à une campagne limitée dans le temps peut perdre une grande partie de son intérêt avant que Google ne traite sa nouvelle version. Parallèlement, les requêtes inutiles peuvent augmenter la charge du serveur et compliquer l’analyse des journaux, car les véritables signaux d’exploration se retrouvent noyés parmi des URL à paramètres répétitives. C’est pourquoi le travail sur le budget d’exploration doit être lié aux priorités éditoriales et commerciales. La bonne question n’est pas « Comment faire pour que Googlebot explore davantage ? », mais plutôt « Quelles URL méritent d’être explorées régulièrement et quels éléments du site détournent Googlebot de ces pages ? ». Cette approche conduit à des corrections plus utiles et permet d’éviter des modifications techniques qui n’apportent aucune amélioration à la visibilité dans les résultats de recherche.
D’où viennent généralement les URL inutiles sur les sites d’affiliation
Les paramètres de suivi figurent parmi les sources les plus fréquentes d’adresses dupliquées sur les sites d’affiliation. Les équipes marketing peuvent ajouter des balises UTM, des identifiants de campagne, des identifiants de clic, des valeurs de sous-identification ou des paramètres de source aux liens afin d’attribuer correctement les visites et les conversions. Ces paramètres sont utiles pour l’analyse des performances, mais ils ne devraient pas créer une deuxième version interne de chaque article, avis ou page de catégorie. Les problèmes commencent souvent lorsque des URL contenant des paramètres apparaissent dans la navigation, les modules de contenus associés, les fichiers sitemap XML ou d’autres liens internes accessibles aux robots. Googlebot considère alors chaque variante comme une adresse supplémentaire qu’il peut devoir demander avant de comprendre sa relation avec la page d’origine. La méthode la plus sûre consiste à conserver des liens internes propres et canoniques, à utiliser le suivi uniquement lorsqu’il est réellement nécessaire et à éviter que les besoins d’analyse ne deviennent une source permanente d’URL supplémentaires.
Les filtres et les options de tri peuvent créer un problème encore plus important, car une seule page peut produire des milliers de combinaisons. Un annuaire d’affiliation peut permettre aux utilisateurs de filtrer les résultats par pays, moyen de paiement, type de produit, note, fonctionnalité ou fournisseur, puis de trier les mêmes résultats de plusieurs façons. Si chaque combinaison crée une URL explorable, le nombre d’adresses possibles peut augmenter beaucoup plus rapidement que le volume réel de contenu. Les recommandations de Google concernant la navigation à facettes avertissent précisément que ce type de configuration peut entraîner une exploration excessive et ralentir la découverte des URL utiles. Si certaines combinaisons filtrées n’ont pas vocation à apparaître dans les résultats de recherche, elles ne devraient pas créer un espace d’exploration pratiquement illimité. Si certaines pages filtrées répondent en revanche à une véritable demande de recherche, elles doivent être traitées comme des pages de destination intentionnelles, avec des URL stables, un contenu utile et des liens internes clairs, et non comme de simples sous-produits accidentels du système de filtrage.
Parmi les autres sources fréquentes de gaspillage du budget d’exploration figurent les pages de résultats de recherche interne, les archives par balises ou par dates, les versions imprimables, les URL de prévisualisation, les identifiants de session, les chemins de pagination dupliqués, les combinaisons de catégories vides, les anciennes pages de campagne, les longues chaînes de redirections et les soft 404. Ces dernières méritent une attention particulière, car une page peut renvoyer une réponse normale avec le code 200 tout en indiquant dans les faits qu’aucun contenu utile n’est disponible. Google peut continuer à demander de telles adresses parce que le serveur continue à les présenter comme des pages valides. Les grands sites d’affiliation accumulent également d’anciennes URL après des changements de partenaires, des migrations ou la suppression de contenus. Si ces adresses restent présentes dans la navigation, les sitemaps ou les liens internes, le site continue à les signaler aux robots. Un audit efficace consiste donc d’abord à regrouper les URL par modèle plutôt qu’à examiner chaque page individuellement. Lorsque les principaux modèles ont été identifiés, l’équipe SEO peut déterminer quels groupes doivent rester indexables, lesquels doivent être redirigés, lesquels doivent renvoyer un code d’erreur et lesquels ne devraient pas être explorés.
Contrôler les URL auxquelles Googlebot consacre son temps
La gestion la plus efficace du budget d’exploration commence par un inventaire des URL plutôt que par une modification immédiate du fichier robots.txt. Chaque type récurrent d’URL doit avoir un objectif clairement défini. Les pages qui répondent à une intention de recherche distincte et apportent une réelle valeur peuvent rester indexables : par exemple, des avis originaux, des comparatifs régulièrement entretenus, des pages de catégories utiles, des guides adaptés à un marché précis et des contenus éditoriaux répondant à une véritable question. Les URL servant uniquement à des fonctions techniques appartiennent généralement à une autre catégorie : les recherches internes, les états de tri, les variantes de suivi, les adresses associées aux sessions et les vues dupliquées du même contenu ont rarement besoin d’une visibilité indépendante dans les moteurs de recherche. Cette classification évite une erreur fréquente dans les grands projets SEO : appliquer une règle technique très large avant de vérifier si certaines URL concernées génèrent réellement du trafic qualifié ou soutiennent des parcours utilisateurs importants.
Le maillage interne et les fichiers sitemap XML doivent ensuite renforcer cette classification. Google utilise les liens accessibles aux robots pour découvrir les pages, de sorte que les pages d’affiliation importantes doivent être accessibles par des liens standards depuis d’autres pages utiles plutôt que dépendre d’URL orphelines ou d’actions uniquement déclenchées par JavaScript. Les sitemaps doivent contenir les URL canoniques que le site souhaite réellement soumettre à Google, et non toutes les adresses que le serveur est capable de générer. Pour les pages mises à jour, une valeur de dernière modification exacte peut aider à signaler qu’un contenu a changé, mais elle doit correspondre à une véritable mise à jour. Google indique qu’il ignore les valeurs de priorité et de fréquence de modification des sitemaps ; il est donc inutile de les remplir avec des paramètres artificiels. Sur les grands sites, des fichiers sitemap propres sont davantage utiles lorsqu’ils servent de catalogue fiable des URL préférées plutôt que de répertoire contenant toutes les adresses connues.
Les URL dupliquées doivent être réduites à la source chaque fois que cela est possible. Si deux adresses renvoient durablement vers le même contenu et que l’une des versions n’a plus d’utilité, une redirection permanente est généralement plus claire que le maintien indéfini des deux versions. Si des pages dupliquées ou très similaires doivent rester accessibles, une balise canonique peut indiquer la version privilégiée, tandis que la cohérence des sitemaps et des liens internes peut renforcer ce choix. La canonicalisation reste toutefois un signal et non une instruction absolue, et elle ne doit pas être utilisée comme moyen principal pour empêcher Googlebot de demander de grandes quantités d’URL indésirables. L’amélioration la plus importante consiste généralement à empêcher la création ou le maillage de variantes inutiles dès le départ. Sur les sites d’affiliation, cela nécessite souvent que les équipes SEO, développement, analyse et commerciales s’accordent sur une politique d’URL commune et propre afin que de nouvelles règles de suivi ou de merchandising ne recréent pas le même problème quelques semaines plus tard.
Robots.txt, balises canoniques, noindex et codes de statut ont des fonctions différentes
Le fichier robots.txt est utile lorsqu’un groupe d’URL ne doit pas être exploré du tout, notamment certaines combinaisons répétitives de filtres ou de tri qui n’ont aucune valeur prévue dans les résultats de recherche. Il peut réduire les requêtes vers ces zones, mais il ne constitue pas une méthode fiable pour supprimer une URL des résultats de Google. Une URL bloquée peut rester connue grâce aux liens, même lorsque Googlebot n’est pas autorisé à récupérer son contenu. La directive noindex fonctionne selon une logique différente : Google doit pouvoir explorer la page afin de voir cette instruction. C’est pourquoi bloquer une URL avec robots.txt tout en espérant que Google lise sa directive noindex est contradictoire. Cela signifie également que noindex n’est pas uniquement un outil permettant d’économiser le budget d’exploration : Googlebot doit tout de même demander la page avant de pouvoir appliquer la directive. Le choix doit donc dépendre de l’objectif recherché : contrôler l’exploration avec robots.txt, contrôler l’éligibilité à l’indexation avec noindex et ne pas considérer ces deux mécanismes comme interchangeables.
Les codes de statut sont tout aussi importants pour les anciennes URL d’affiliation et les adresses invalides. Si une page a été définitivement supprimée et qu’il n’existe aucun remplacement pertinent, renvoyer un code 404 ou 410 donne à Google un signal clair indiquant que cette ancienne adresse ne doit plus recevoir la même attention d’exploration. Les combinaisons de filtres vides et les états de pagination impossibles devraient également renvoyer un véritable code 404 au lieu d’une page normale se contentant d’indiquer qu’aucun résultat n’est disponible. Si une page supprimée possède un successeur précis répondant au même besoin de l’utilisateur, une redirection permanente vers cette page de remplacement est appropriée. Rediriger chaque avis ou page de campagne expirée vers la page d’accueil ne remplace pas une véritable décision sur le devenir du contenu, et les longues chaînes de redirections imposent un travail supplémentaire aux robots comme aux utilisateurs. L’objectif est que chaque ancienne URL communique son véritable état sans ambiguïté.
Les contenus commerciaux expirés nécessitent une décision éditoriale et non l’application automatique d’une règle technique. Certaines anciennes pages d’offres perdent toute utilité lorsqu’une campagne prend fin ; d’autres continuent à attirer des recherches pertinentes parce que les utilisateurs souhaitent consulter d’anciennes conditions, connaître les alternatives actuelles ou comprendre ce qui a changé. Si une page conserve une fonction distincte, elle peut rester en ligne avec un statut exact, des informations actualisées et des liens utiles vers les options actuelles. Si elle a été remplacée par une page répondant pratiquement au même besoin, une redirection peut permettre de consolider le parcours. Si elle n’a plus aucune valeur durable et aucun remplacement approprié, sa suppression accompagnée d’une véritable réponse d’erreur est plus propre que le maintien de milliers de pages 200 peu utiles. Cette question est particulièrement importante pour les sites d’affiliation qui publient des promotions saisonnières ou changent régulièrement de partenaires commerciaux, car le volume de pages expirées peut augmenter chaque mois si le retrait des contenus ne fait pas partie du processus éditorial normal.
Mesurer l’efficacité de l’exploration et maintenir les pages importantes à jour
Le rapport Statistiques sur l’exploration de Google Search Console constitue le point de départ pour vérifier la manière dont Google interagit avec un grand site. Il indique le nombre total de requêtes d’exploration, la taille totale des téléchargements, le temps de réponse moyen, l’état des hôtes, les types de réponses, les types de fichiers, l’objectif de l’exploration et le type de Googlebot. Ces données permettent de repérer des changements soudains dans l’activité d’exploration, des problèmes de serveur, un nombre excessif de redirections ou une augmentation des réponses d’erreur. Ce rapport est destiné aux utilisateurs avancés et les URL qu’il présente ne constituent que des exemples ; il ne doit donc pas être considéré comme une liste exhaustive de toutes les adresses demandées par Googlebot. Pour un site d’affiliation comportant de nombreux modèles d’URL, Search Console est particulièrement utile pour observer les tendances et repérer les anomalies. Lorsque l’équipe doit déterminer précisément quels modèles ou paramètres consomment le plus de ressources d’exploration, les journaux du serveur fournissent une vision plus détaillée.
Un tableau de suivi de l’efficacité de l’exploration n’a pas besoin de contenir des dizaines d’indicateurs. Il suffit notamment de suivre la proportion de requêtes Googlebot consacrées aux pages canoniques indexables, les principaux groupes de requêtes vers des URL inutiles, la part des réponses 3xx, 4xx et 5xx, le temps de réponse moyen ainsi que la rapidité avec laquelle les nouvelles pages importantes ou les pages fortement mises à jour sont explorées pour la première fois. Il n’existe aucun pourcentage universellement « correct » pour ces indicateurs, car les sites diffèrent par leur taille, leur fréquence de publication et leur configuration technique. L’intérêt réside dans la comparaison des tendances. Si le nombre d’URL filtrées demandées chute nettement après une correction tandis que l’exploration des sections importantes devient plus régulière, la modification produit un résultat utile. Si le nombre total de requêtes diminue mais que les nouveaux contenus restent lents à être découverts, l’équipe doit examiner le maillage interne, la qualité des sitemaps, la valeur du contenu et la santé du serveur plutôt que de considérer une diminution du volume d’exploration comme un succès en soi.
La stabilité du serveur est importante, car Google adapte sa capacité d’exploration à la manière dont un site répond aux requêtes. Des erreurs 5xx persistantes, des réponses de limitation telles que 429, une latence accrue ou des temps de réponse plus longs peuvent conduire Google à réduire son rythme d’exploration. Une infrastructure plus rapide et plus stable facilite donc l’exploration sans qu’il soit nécessaire d’imposer artificiellement une fréquence particulière. La mise en cache HTTP peut également limiter les transferts inutiles lorsque le contenu n’a pas changé ; les recommandations de Google précisent qu’une réponse 304 « Not Modified » peut permettre de réutiliser le contenu déjà présent en cache. Pour les équipes éditoriales, l’enseignement est simple : publier davantage d’URL ne peut pas compenser l’instabilité technique d’un site. Si un grand site d’affiliation prévoit de mettre à jour des milliers de pages au cours d’une campagne saisonnière, la capacité d’hébergement, le comportement du cache et le calendrier de publication doivent être préparés en même temps que le contenu.
Une routine pratique de gestion du budget d’exploration pour les équipes SEO en 2026
Une routine efficace commence par une analyse hebdomadaire de la croissance des URL et de l’indexation par type de page. Comparez le nombre de pages réellement publiées par l’entreprise avec le nombre total d’URL générées par le site. Si 500 nouveaux avis ont été ajoutés mais que 40 000 nouvelles adresses explorables sont apparues, il faut identifier leur origine avant que le problème ne prenne davantage d’ampleur. Vérifiez dans Search Console l’évolution du nombre de pages connues et indexées, examinez le volume des sitemaps et contrôlez les nouvelles URL éditoriales et commerciales les plus importantes afin de vous assurer qu’elles disposent de liens internes. Cette méthode permet de maintenir le travail sur le budget d’exploration directement lié à l’activité éditoriale réelle. Elle permet également de détecter les modifications accidentelles provoquées par de nouveaux filtres, de nouvelles règles de suivi, une refonte ou des paramètres du CMS avant que des millions d’URL inutiles ne s’accumulent.
Une fois par mois, combinez les tendances observées dans Search Console avec un échantillon des journaux du serveur et classez le gaspillage par modèle d’URL. Commencez par les modèles générant le plus grand volume tout en apportant le moins de valeur pour la recherche. Corrigez d’abord la génération des URL et les liens internes, puis appliquez, si nécessaire, les contrôles d’exploration ou d’indexation appropriés. Supprimez les anciennes URL des sitemaps, raccourcissez les chaînes de redirections, corrigez les soft 404 et vérifiez que les pages canoniques importantes ne sont pas bloquées par erreur. Après une modification, laissez à Google suffisamment de temps pour réexplorer les zones concernées et comparez plusieurs cycles d’exploration plutôt que d’évaluer le résultat sur les données d’une seule journée. Les grands sites restent souvent longtemps associés à d’anciennes URL dans les systèmes de Google, de sorte que les améliorations apparaissent généralement sous la forme d’une tendance progressive plutôt que d’une réinitialisation immédiate.
La règle finale consiste à considérer le budget d’exploration comme un élément de bonne gestion du site, et non comme un raccourci permettant d’améliorer les positions. Google ne garantit pas qu’une page explorée sera indexée, et un volume d’exploration plus important ne rend pas un contenu faible plus compétitif. Les équipes SEO travaillant dans l’affiliation obtiennent de meilleurs résultats en combinant un inventaire d’URL propre avec des contenus originaux, une architecture interne claire, des sitemaps exacts, des serveurs stables et une gestion rigoureuse des contenus arrivés en fin de vie. En 2026, les recommandations de Google continuent à mettre l’accent sur la maîtrise des URL dupliquées ou indésirables, la mise à jour correcte des informations des sitemaps et le maintien d’une bonne santé technique du serveur. Lorsque ces principes fondamentaux sont correctement appliqués, Googlebot a moins de raisons de consacrer du temps à des impasses et davantage d’occasions de traiter les pages dont l’activité du site dépend réellement.